Model-To-Code: A Engine que Escrevia Código Sozinha Antes de a IA Virar Moda
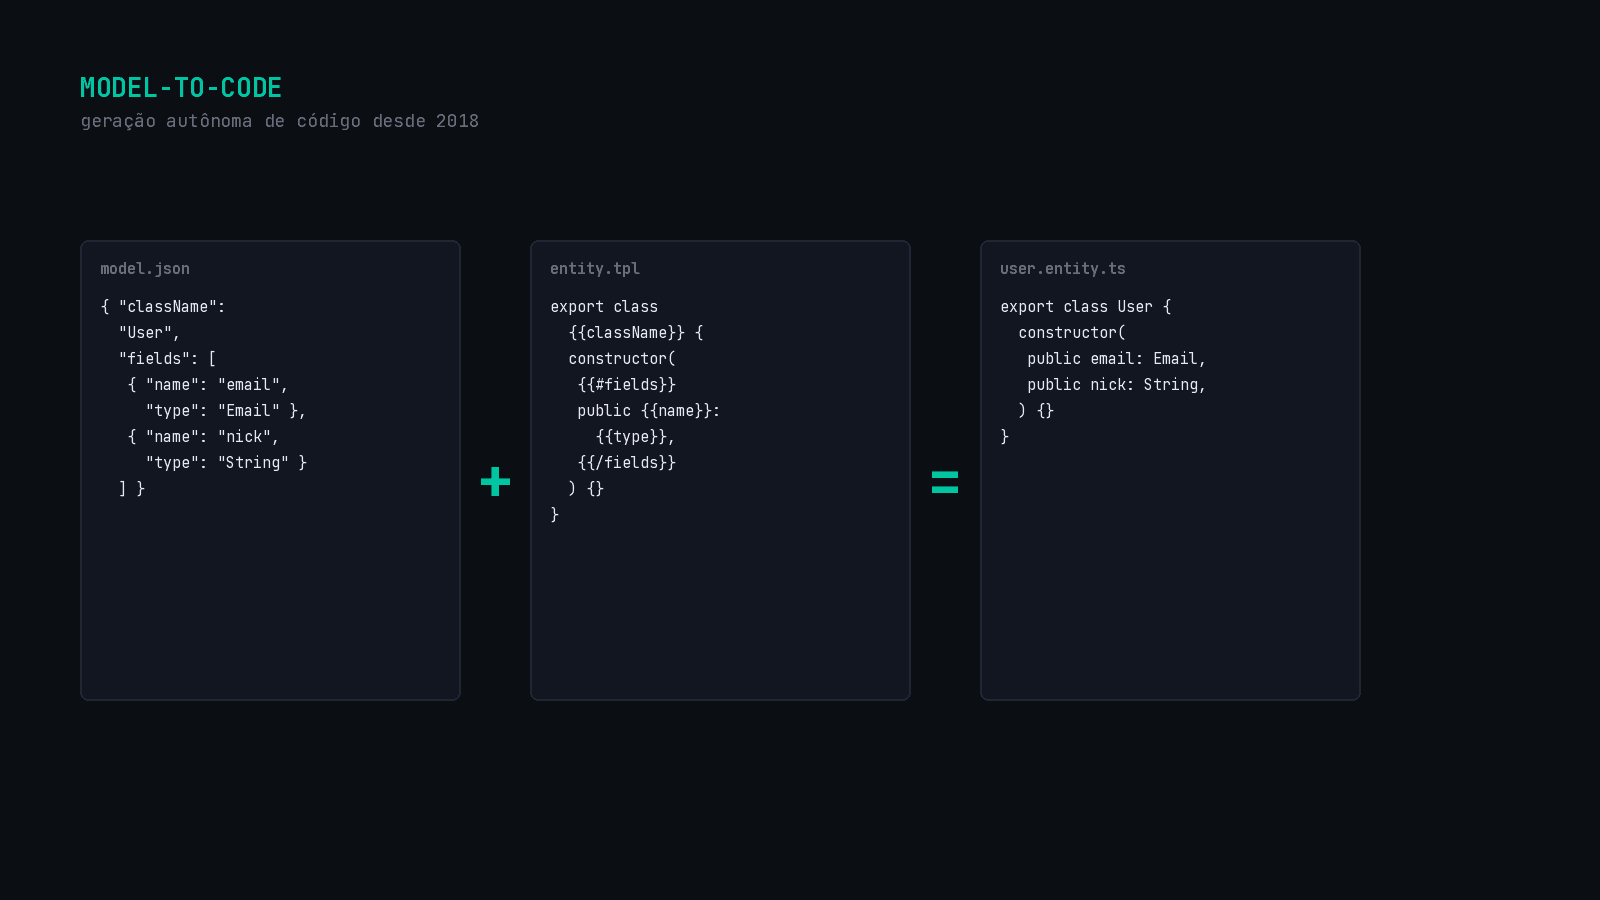
Em 2018, uma ferramenta chamada Model-To-Code já transformava um diagrama de entidades em camadas inteiras de aplicação. Oito anos depois, ganhou um copiloto de IA.
Em agosto de 2018, uma ferramenta chamada Model-To-Code já transformava um diagrama de entidades em camadas inteiras de aplicação. Oito anos depois, ela continua gerando código determinístico — e ganhou um copiloto de linguagem natural.
A equação que sustenta o projeto está escrita no primeiro teste unitário e não mudou desde então:
model.json  +  entity.tpl  =  user.entity.ts

{ "className": "User",          export class {{className}} {         export class User {
  "fields": [                     constructor(                         constructor(
   { "name": "email",               {{#fields}}                          public email: Email,
     "type": "Email" },             public {{name}}: {{type}},           public nick: String,
   { "name": "nick",                {{/fields}}                        ) {}
     "type": "String" }           ) {}                                }
  ] }                            }
Um único modelo. Um único template. Quantos arquivos forem necessários — sempre idênticos, sempre na mesma arquitetura. O tutorial público está em github.com/murilordg/m2c-tutorial.
Uma história que começa antes do hype
- 2018 — Nasce o CodeGen-FrontEnd: um modelador visual em Angular com diagramas de entidades, casos de uso e editor embutido. A primeira engine de geração roda no navegador e já produz scripts SQL, DAL, controllers, views e models.
- 2021 — A engine é reescrita do zero em TypeScript sobre Node e Express, vira um servidor de geração com API HTTP e passa a rodar em contêineres com processamento em cluster.
- 2023 — Chegam os partials de uso antecipado, o parser de SQL e a leitura de contratos OpenAPI 3, que viram modelos prontos para gerar clientes e servidores.
- 2025 — O núcleo é enxugado e ganha uma segunda vida como CLI. Entram funções JavaScript chamáveis pelo template, geração multi-entidade e um módulo de IA com LangChain e modelos locais via Ollama.
O problema: toda aplicação repete a mesma coreografia
Uma entidade nasce no banco, ganha uma classe de domínio, um DTO, um repositório, um controller, um formulário, uma validação. Cinco ou dez arquivos que diferem apenas em nomes, tipos e cardinalidades. Escrever isso à mão é lento e propenso a erro; copiar e colar é pior.
O conhecimento sobre a entidade mora no modelo, e o conhecimento sobre a arquitetura mora no template. A engine junta os dois e devolve código pronto em milissegundos, sem esquecer nenhum campo.
Uma linguagem de templates que pensa como programador
Quem já usou Mustache reconhece a base. O que o Model-To-Code adiciona resolve dores reais que o Mustache clássico deixa em aberto:
- Pipes de nomenclatura — 18 transformações prontas (
pascal,camel,kebab,snakeUpper...) para levartb_cp_historicoaTbCpHistorico,tbCpHistoricooutb-cp-historicoconforme o contexto do arquivo gerado. - Metadados de laço —
:first,:last,:indexe variantes resolvem a vírgula sobrando e a numeração de parâmetros, mesmo em laços aninhados. - Filtros inline e switch-case — mapear um tipo de coluna do banco para um tipo da linguagem de destino é o caso de uso número um de qualquer gerador; aqui é uma estrutura de primeira classe.
- Partials com argumentos e uso antes da declaração — um partial vira uma função com parâmetros, e uma marca especial permite preencher o topo do arquivo (os imports) só depois de percorrer o corpo inteiro — o problema clássico de geração de código que a maioria dos motores populares não resolve sem pós-processamento.
- Múltiplos arquivos de um só template — uma marca de corte decide para qual arquivo cada trecho vai, permitindo que um único template gere uma feature inteira: entidade, DTO e controller de uma vez.
O núcleo tem pouco mais de duas mil linhas de TypeScript, cobertas por 22 suítes e 270 testes, com 96% de cobertura — a mesma disciplina de precisão que aplicamos em qualquer motor que vira infraestrutura de produção.
Onde o LLM entra na história
Em 2018, a aposta era que código é uma função determinística de um modelo. Em 2023, o mundo descobriu que um LLM consegue escrever código a partir de linguagem natural. As duas abordagens não competem — elas se completam.
O LLM extrai o modelo
Um módulo de IA usa LangChain com modelo local via Ollama, sem enviar código para nenhuma nuvem, para ler um schema Prisma e devolver um modelo pronto para a engine. O LLM interpreta a fonte semiestruturada; a engine gera dezenas de arquivos idênticos toda vez que roda.
O LLM faz o merge
Quando o desenvolvedor edita o arquivo gerado e o modelo muda, regenerar apagaria o trabalho manual. Prompts de merge instruem o modelo a preservar a lógica adicionada pela pessoa e incorporar os campos novos — a peça que faltava para geração contínua.
Por que não deixar o LLM fazer tudo? Porque um LLM é probabilístico e um template é determinístico. Em uma base com duzentas entidades, a exigência é que todas as duzentas sigam exatamente a mesma arquitetura, a mesma indentação, os mesmos imports — e que revisar qualquer uma delas seja trivial porque todas são iguais. O template é, na prática, um skill auditável: codifica a opinião arquitetural do time de forma versionável, revisável e testável. O LLM alimenta o template com modelos e cuida das arestas que exigem interpretação; essa divisão de trabalho é o que separa um protótipo impressionante de um pipeline de produção.
O que um projeto de oito anos revela
Manter um projeto por oito anos, atravessando três gerações de front-end, uma reescrita completa de engine e a chegada dos LLMs, exige mais do que domínio técnico pontual:
- Visão de arquitetura antes da ferramenta. A ideia de separar modelo e template resistiu a todas as mudanças de tecnologia porque estava certa desde o início.
- Obsessão por qualidade de saída. Controle de espaços em branco, indentação e seis convenções de nomenclatura são cicatrizes de código que precisou passar por revisão de gente exigente.
- Domínio de ponta a ponta. TypeScript, Node, Angular, Docker, LangChain, Ollama, modelagem de dados, OpenAPI, SQL — tudo convivendo com propósito claro no mesmo repositório.
- Capacidade de enxugar. Em 2025, partes do núcleo saíram para deixar a engine mais leve. Saber tirar é tão importante quanto saber colocar.
Quando essa abordagem se paga
Scaffolding de arquitetura corporativa, migração de sistemas legados, geração a partir de contratos (OpenAPI, Prisma, YAML de domínio) e pipelines híbridos que combinam LLM para interpretação com engine determinística para geração — são cenários em que essa combinação de modelo, template e IA costuma encurtar meses de trabalho, sem abrir mão de governança sobre o que é gerado.
Sua equipe reescreve manualmente a mesma estrutura de código a cada nova entidade ou integração? Podemos avaliar se um pipeline de geração — determinístico, apoiado por IA onde faz sentido — encurta esse ciclo.
→ Iniciar meu projetoArtigos Relacionados
Quem Criou Quem: o Homem Criou a IA ou a IA Criou o Homem?
Uma pergunta que parece papo de bar — até você perceber que ela já está sendo levada a sério, e que talvez a gente nunca tenha certeza de nada.
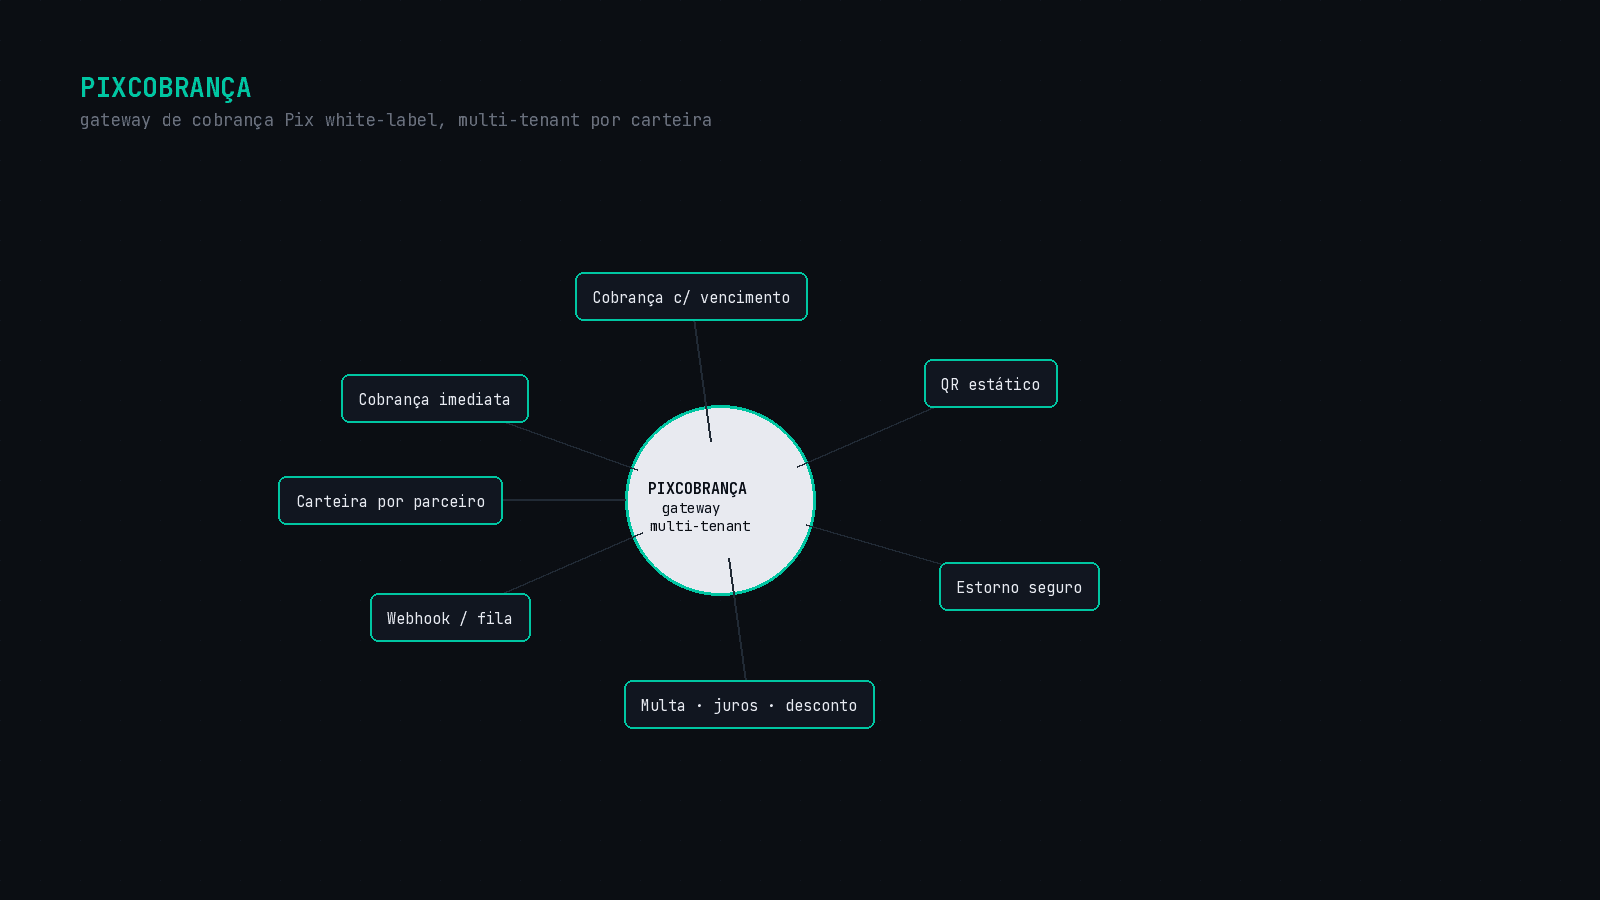
PixCobrança: o Boleto Registrado Reinventado com Liquidação Instantânea
Como um gateway de cobrança Pix multi-tenant, organizado por carteiras isoladas por parceiro, cobre o mesmo terreno do boleto registrado — vencimento, multa, juros e desconto — com liquidação em segundos.
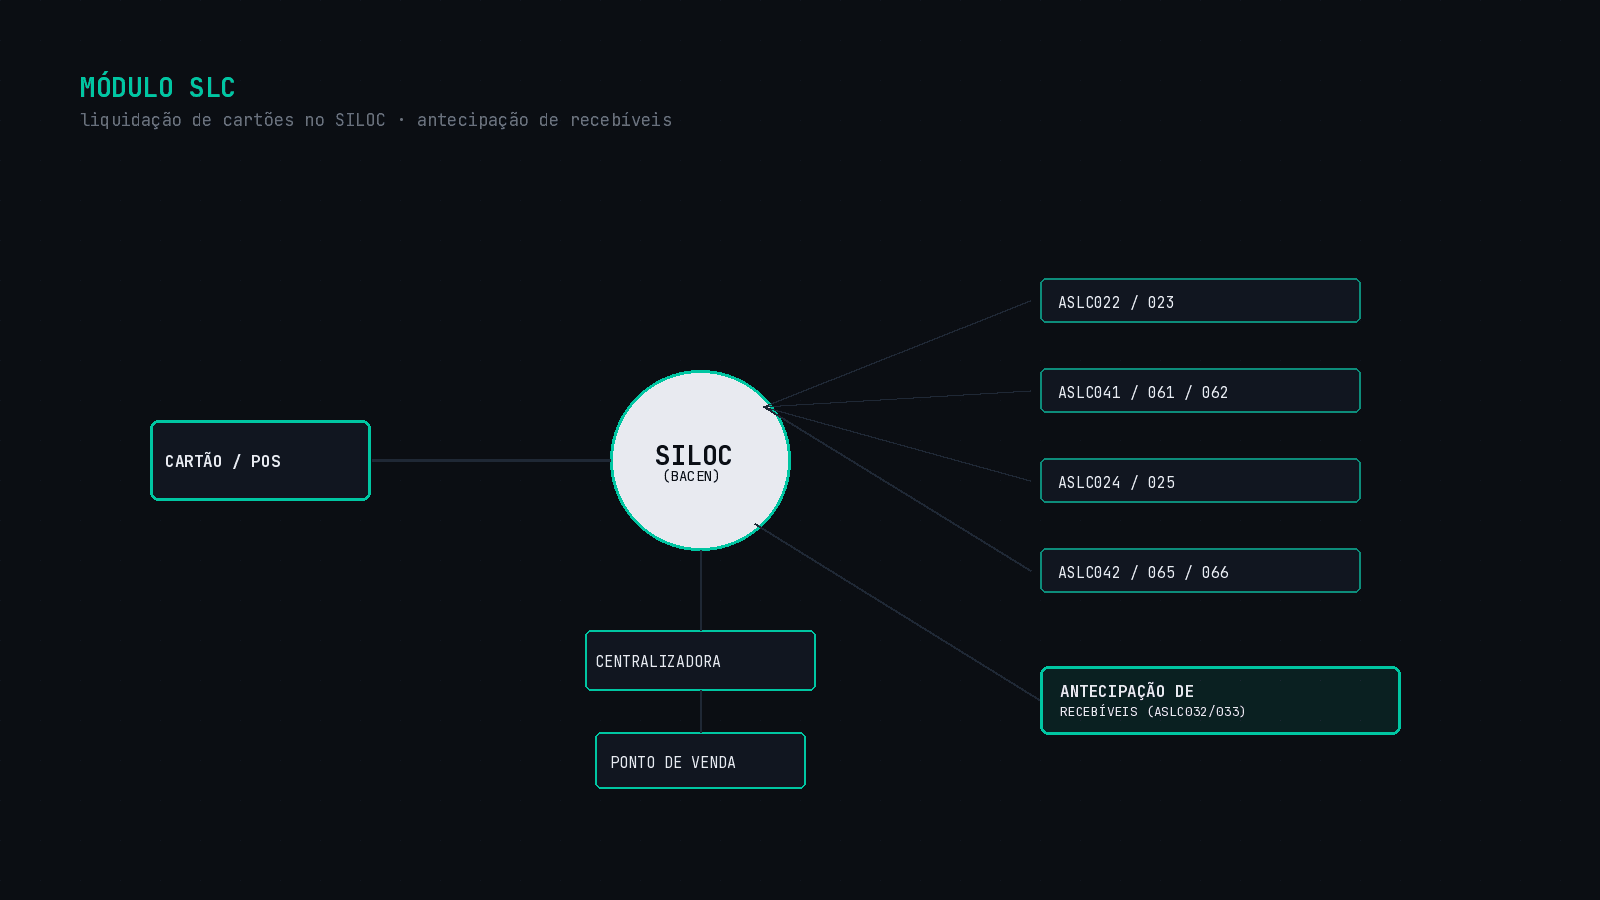
Módulo SLC: a Infraestrutura por Trás da Liquidação de Cartões no SILOC
Como um módulo de liquidação de cartões conecta credenciadoras e instituições de pagamento ao SILOC do Banco Central — e por que essa camada, uma vez resolvida, também abre a porta para antecipação de recebíveis.